全国产芯片训练的大模型来了!百万上下文,价格比DeepSeek V4.1 Flash更低
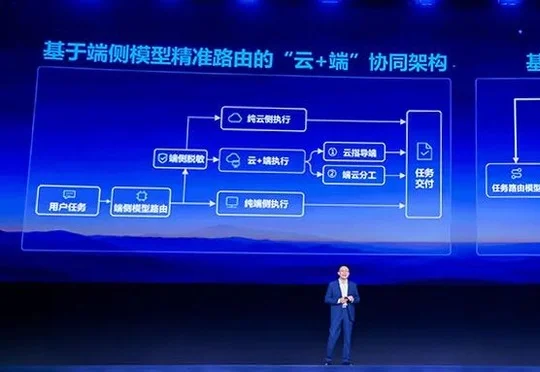
全国产芯片训练的大模型来了!百万上下文,价格比DeepSeek V4.1 Flash更低科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
搜索
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
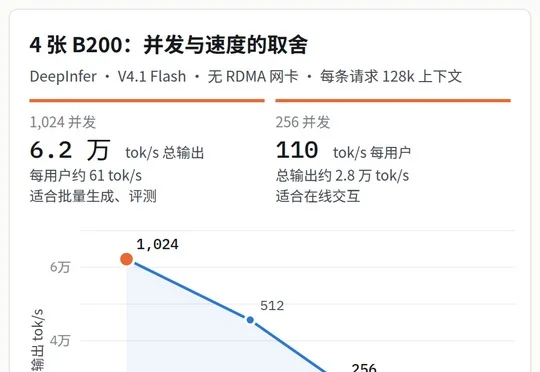
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
昨天,DeepSeek 直接把自家压箱底的「印钞机」技术给开源了。
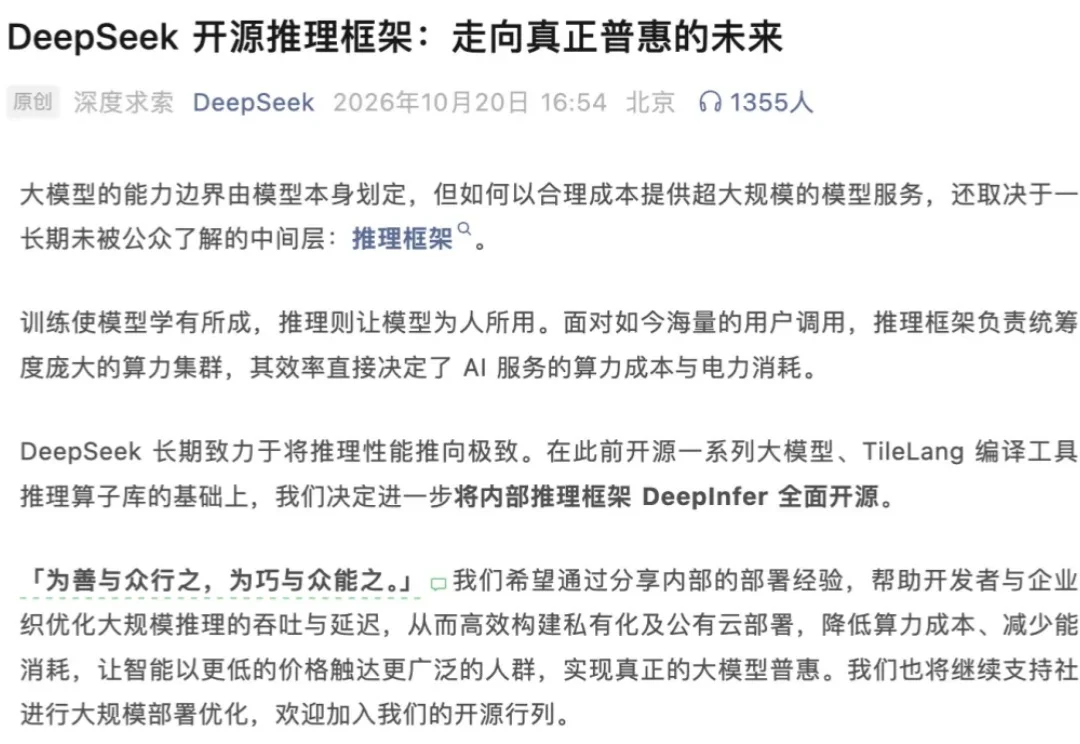
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
永远不要相信 DeepSeek 的 “a minor update” (小更新)。
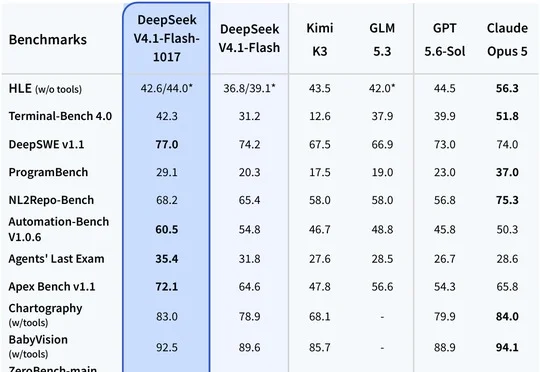
DeepSeek官宣DeepSeek-V4.1-Flash-1017全面上线,网页、App和API同步更新且价格不变,在DeepSWE v1.1取得77%最高分,并开放MIT许可证权重及Search/Fetch搜索API。
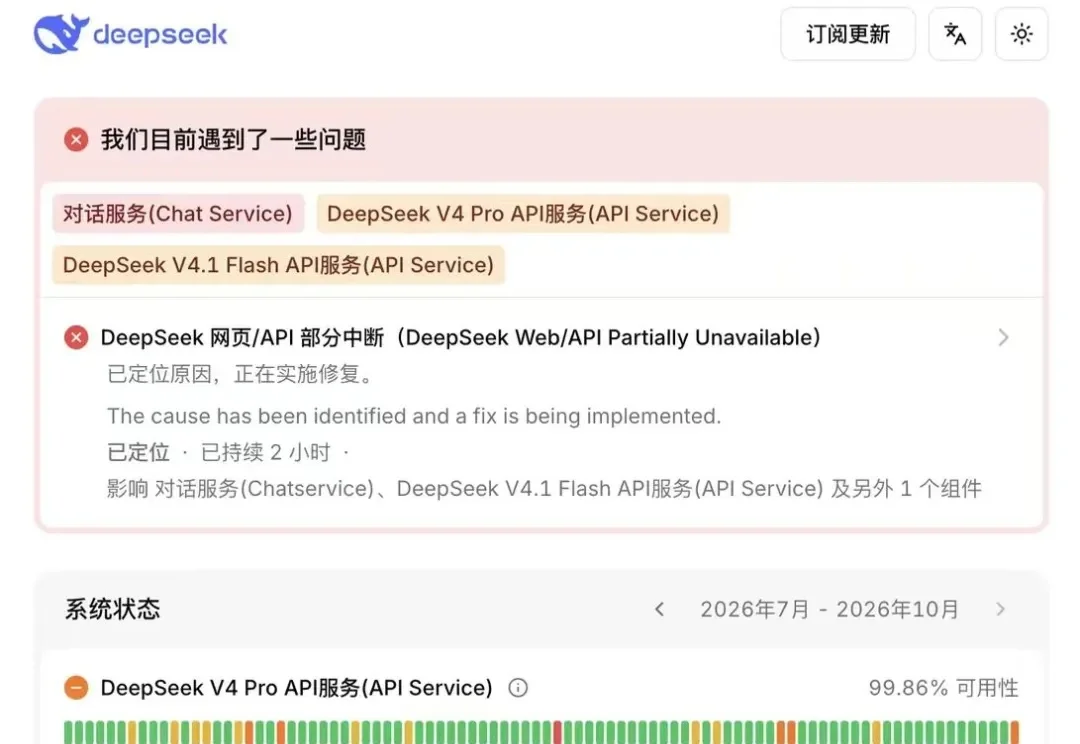
补偿款来了,DeepSeek 发 Token 了。
DeepSeek Harness 给每个用户定制了一套工作台,PenguinHarness 给每个 Agent 定制了一套工作台。
DeepSeek 连自己官方开源的推理代码都能写错,而且错得相当有规律。
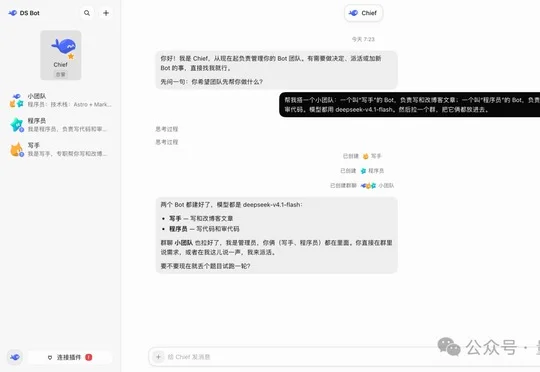
非官方 DeepSeek-Bot 基于 DeepSeek Harness 以 DSH 插件形式上线,支持多 Bot 独立角色与模型、长期记忆及主管协同,并可通过 DSH 桌面端和 Web 端安装使用。